Ce qu'il a fallu pour faire confiance à un gestionnaire de paquets écrit par Claude
Traduit de l'anglais avec l'IA. Lire l'original
Je n’ai pas écrit, ni même lu, une seule ligne de code pour faire jpm, un gestionnaire de paquets JavaScript qui fonctionne dans les projets npm, pnpm, yarn et bun. Y compris quand j’ai demandé à l’IA d’écrire son propre module TLS, cryptographie et HTTP pour le rendre plus léger. Au départ, c’était un vrai projet en vibe coding. En plus, c’était fini en un après-midi. Ni moi ni personne n’aurait dû lui faire confiance dans cet état, mais ensuite j’ai mis à profit ce que j’ai appris en plus de 27 ans comme ingénieur logiciel professionnel : je l’ai fait tester contre des suites de tests existantes, et pendant cinq jours je lui ai fait écrire et tester à fond son propre code pour le durcir.
D’où je viens
J’ai utilisé beaucoup de langages de programmation dans ma carrière, mais surtout des langages de haut niveau comme C#, Elixir et JavaScript. Je n’avais pas utilisé de langage bas niveau pour plus que deux ou trois fonctions depuis que j’étais gamin, quand j’apprenais le C et que j’aidais mon père l’été, à son boulot, sur des contrôleurs de disque bas niveau. Donc me mettre à Rust et construire un projet de plus de 60k lignes avec, ce n’était pas quelque chose que j’aurais pu faire en peu de temps. Ce que j’ai appris, en revanche, c’est comment fonctionnent npm, pnpm et bun, puisque j’utilise Node.js professionnellement depuis Node.js 0.8 (2012). Je sais aussi combien de tests un logiciel demande vraiment, et à quel point il compte de les automatiser au lieu de les faire une seule fois. Tous ces gars de l’agile qui me disaient d’écrire les tests d’abord avaient bien raison !
Pourquoi jpm
Je regardais un podcast sur YouTube qui s’appelle Syntax avec les animateurs Wes, Scott et CJ, où ils ont commencé l’épisode en parlant d’upm, un gestionnaire de paquets rapide et vraiment petit, mais écrit en JavaScript. Ma première pensée, c’est que l’argument de la taille était faux, parce qu’il faut inclure le runtime Node.js, ou un runtime quelconque. C’est Pooya qui l’avait écrit, et CJ présentait les benchmarks fournis par le projet, qui le montraient rapide, mais moi je voulais juste voir si on pouvait faire plus rapide. Pooya est un bon ingénieur qui fait plein de bons outils pour l’écosystème JavaScript, donc je savais que ce ne serait pas facile. Enfin, j’utilisais Opus 5.5 comme modèle depuis un moment et il me bluffait complètement. Alors je me suis dit que, vu que tant d’autres outils ont été écrits en Rust, ils en ont même plaisanté dans le podcast, je pourrais peut-être faire un gestionnaire de paquets vraiment petit et rapide en Rust.
Dans le podcast, les animateurs répondaient à des questions de leur public sur l’IA, des questions que tout le monde se pose en ce moment. Est-ce qu’elle peut construire de vrais logiciels, ou juste des démos ? Est-ce que les ingénieurs devraient s’inquiéter, ou se réjouir ? La plupart des gens pensent que l’IA peut tout faire du premier coup. Spoiler : elle en est capable. Simplement, les résultats ne sont pas bons si on ne la dirige pas et qu’on ne comprend pas le développement logiciel.
L’après-midi
Donc cet après-midi-là, alors que je terminais ma journée de boulot, j’ai ouvert un onglet dans mon terminal et j’ai demandé à Claude ce qu’il faudrait pour réécrire upm en CLI Rust. J’ai lu le résumé, j’ai donné mon feu vert et il s’y est mis. Je crois que ça a pris peut-être 45 minutes, et il avait une version qui marchait, avec tout un tas de crates Rust tierces qui la rendaient beaucoup plus grosse, et testée seulement sur un petit fichier package.json. Pour la rendre plus petite, je lui ai fait détailler ce qui la rendait si grosse, et à la fin de la soirée j’avais un module HTTP, JSON, cryptographie et TLS maison et un binaire beaucoup plus petit. Je lui ai bien dit de n’écrire que les parties dont on avait besoin, mais aussi de les tester à fond avec les tests d’autres projets quand c’était possible, ou avec les nôtres, avec un peu de fuzz testing. Je voulais être sûr qu’elles soient solides.
Les cinq jours
Voilà donc la partie que tous ceux qui font des projets en « vibe coding » passent sous silence. Bien sûr, je l’avais fait marcher sur un petit fichier package.json, sous Linux dans WSL2 sur Windows, mais je ne l’avais pas testé sur Mac ni sur Windows, ni sur aucun projet vraiment gros. Alors je lui ai fait écrire un script pour le durcir, qui prenait 100, puis au final 166, gros projets publics et essayait de les installer et de les builder. Ensuite, les installer et les builder avec le gestionnaire de paquets qu’ils utilisent, et comparer. Y compris lancer leurs tests quand c’était possible, car certains tests demandaient des secrets ou une autre config. Et faire pareil dans l’invite de commandes Windows et dans PowerShell, pendant que je lançais un agent sur mon Mac pour faire la même chose sur le Mac. Et cinq jours plus tard, après beaucoup de décisions sur quoi prendre en charge et comment, on avait 261 PR mergées et un gestionnaire de paquets durci et bien testé.
Diriger, en pratique
Donc je n’ai pas écrit de code, mais je l’ai bien dirigé et j’ai pris plein de petites décisions. Par exemple, Claude disait qu’un format de lockfile plus rapide ne ferait gagner que quelques ms, mais j’ai quand même demandé le changement. Claude voulait aussi que le store global soit une fonctionnalité optionnelle, mais j’ai fait remarquer que si 99 % des paquets peuvent l’utiliser, à quoi bon, et c’est devenu le comportement par défaut. Je ne voulais pas non plus qu’il lance des scripts, y compris les scripts d’installation des dépendances, sauf si on les avait explicitement autorisés. Mon raisonnement, c’est que l’IA fait l’essentiel du travail maintenant, donc avant d’approuver les scripts d’un paquet, je peux simplement lui demander de les passer en revue d’abord pour repérer les problèmes.
Il y a aussi eu deux fois où Claude m’a vraiment contredit, mais les deux fois j’ai insisté.
La première, c’était le TLS. Je voulais réduire la taille du binaire, et les crates TLS et cryptographie en représentaient une grosse partie. Claude a dit que c’est le genre de code qu’on n’écrit jamais soi-même. Je lui ai répondu que c’était une vieille façon de penser l’ingénierie. On est en Rust, donc les bugs mémoire derrière des trucs comme Heartbleed sont exclus, et on peut tester notre version à fond tout aussi bien, sinon mieux. Il a reconnu qu’il avait exagéré le risque et a détaillé quelles suites de tests le prouveraient (Wycheproof, vecteurs NIST, x509-limbo, BoGo). Je me demande encore si c’est une bonne idée ou pas, et Claude a tendance à vous caresser dans le sens du poil, donc quand il dit qu’il avait exagéré le risque, ça pourrait très bien être juste lui qui essaie de faire plaisir. Il passe tout un tas de tests, y compris des tests tirés de vrais bugs d’autres projets. Je sais que je lui ferais bien plus confiance maintenant, peu importe qui l’a écrit.
La deuxième, c’était HTTP/2. Je voulais plus de vitesse et j’ai posé la question. Claude l’a d’abord testé avec curl et a dit que ça ne valait pas la peine de le construire, parce que l’installation complète de jpm en HTTP/1.1 était déjà plus rapide que le seul téléchargement de curl en HTTP/2. J’ai insisté quand même. curl doit gérer tous les cas, alors que nous, on a juste besoin de plein de GET vers un seul registre. Il faut sortir des sentiers battus pour faire mieux que bun. Il a été d’accord et avait un client fonctionnel environ deux heures plus tard.
Ensuite, on l’a mesuré. Sur ma connexion à la maison, HTTP/2 était environ 17 % plus rapide. Sur les runners de GitHub, il faisait jeu égal ou perdait, était jusqu’à 2x plus lent sur une installation à froid de nuxt, et consommait 8 à 15 % de CPU en plus sur les gros tarballs. La CI, c’est là où les installations coûtent vraiment du temps et de l’argent, et en plus il ajoutait 60 KB au binaire. Alors je lui ai fait supprimer les 3 671 lignes. Là-dessus, j’avais tort, et les chiffres me l’ont dit.
Ça a aussi marché dans l’autre sens. jpm vous installe Node si vous voulez, et je voulais mettre la vérification de signature de Node derrière un flag parce que je pensais qu’elle ralentirait les installations. Claude l’a mesurée entre 15 et 19 ms et a dit qu’un flag, ça veut juste dire que personne ne l’active. Elle est activée par défaut et j’en suis content, parce qu’elle ajoute de la sécurité.
Pourquoi je fais confiance à du code que personne n’a tapé
La réponse courte, c’est Wycheproof, les propres tests de node-semver, pnpm, yarn et bun, et les 166 dépôts sur lesquels on l’a testé. Quelques-uns des bugs qu’ils ont trouvés en chemin :
- Les propres tests de node-semver ont trouvé 25 cas où jpm n’était pas d’accord, comme accepter
^9007199254740991.0.0comme plage de versions. - Au début, seuls 117 tests sur 154 de npm-package-arg passaient.
a@a.tar.gzétait lu comme un tag. - Un scan de sécurité a découvert que le
.npmrcd’un dépôt cloné pouvait envoyer votre token du registre à travers son propre proxy. La preuve de concept a capturéBearer USER-SECRET-TOKEN. Le.npmrcd’un projet ne peut plus abaisser la sécurité. - Sur les vrais dépôts, les liens de dépendances où l’installation de jpm différait de celle de pnpm sont passés de 1 320 à 183, et par rapport à celle de npm, de 614 à 14.
- Sur macOS, ça ne compilait même pas du tout avant que je teste sur macOS.
Je sais aussi, après toutes ces années à construire des logiciels, que rien n’est exempt de bugs, quels que soient les tests qu’on écrit et qu’on lance. Et la confiance, ça se mérite, donc je compte l’utiliser dans tous mes projets à partir de maintenant, et rester ouvert aux corrections, même celles soumises par une IA. Ça ne veut pas dire que je vais toutes les prendre. Elles doivent prouver avec des tests qu’elles corrigent quelque chose. Bref, je ne compte pas désactiver les PR, mais je vais me servir de l’IA pour m’aider à les gérer.
Où il en est
On a ramené l’exécutable à 2MB, et il n’est pas toujours le plus rapide, mais il est tout en haut. C’est aussi l’un des plus sûrs, puisqu’il ne lance pas de scripts sans approbation. Il ne met pas à jour les paquets vers la dernière version si elle n’a pas au moins un jour. Et il y a la sécurité autour du .npmrc.
Voici un des graphiques qui montre à quel point on peut être rapide sur un runner GitHub Actions par rapport aux autres gestionnaires de paquets :
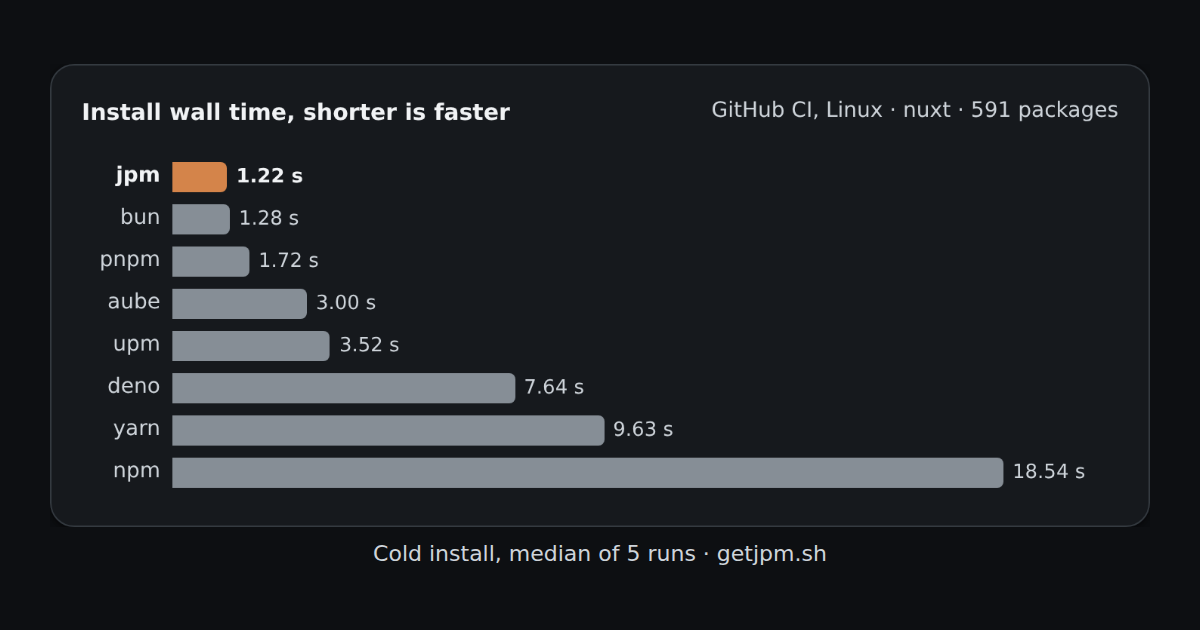
Toutes les machines, phases et projets sont sur getjpm.sh.
Là où il n’est pas le plus rapide
Je vais être honnête : le benchmark est petit, seulement trois dépôts. On n’est pas toujours les plus rapides non plus. Par exemple, sur Windows avec nuxt, les analyses de Defender le plombent. Sur macOS, bun et aube gagnent pour les installations à chaud de nuxt. Il y a donc de la marge de progression si la vitesse est l’objectif final. On a bien lancé des installations de 166 projets sur Linux, macOS et Windows, plus encore d’autres projets au hasard sur Linux pour trouver des bugs, mais on n’a pas testé les performances de chacun en CI et sur des machines.
Est-ce que jpm est parfait ? Non. Pas plus que tout ce que j’ai écrit à la main en 27 ans, ou que tout ce qu’un humain a pu écrire. La perfection n’existe pas. Il y a le suffisamment bon, il y a l’excellent, et il y a le suffisamment testé pour savoir lequel des deux on a.
Essayez-le avec curl -fsSL https://getjpm.sh | sh sur macOS et Linux, ou irm https://getjpm.sh/install.ps1 | iex sur Windows, puis lancez jpm install dans n’importe quel projet. Si vous trouvez un bug, ouvrez une issue sur GitHub.