O que foi preciso para confiar em um gerenciador de pacotes escrito pelo Claude
Traduzido do inglês com IA. Ler o original
Eu não escrevi, nem sequer li, uma única linha de código ao fazer o jpm, um gerenciador de pacotes para JavaScript que funciona em projetos de npm, pnpm, yarn e bun. Isso inclui quando pedi para a IA escrever o próprio módulo de TLS, criptografia e HTTP para deixá-lo menor. No começo, foi um projeto de vibe coding de verdade. E ficou pronto em uma tarde. Nem eu nem ninguém deveria ter confiado nele naquele estado, mas aí eu peguei o que aprendi em mais de 27 anos como engenheiro de software profissional: fiz ele rodar contra suítes de testes existentes e passar cinco dias escrevendo e testando pesado o próprio código para deixá-lo robusto.
De onde eu venho
Já usei muitas linguagens de programação na minha carreira, mas a maioria de alto nível, como C#, Elixir e JavaScript. Eu não usava uma linguagem de baixo nível para mais do que algumas funções desde criança, quando aprendia C e ajudava meu pai, nas férias de verão, com controladoras de disco de baixo nível no trabalho dele. Então aprender Rust e construir com ele um projeto de mais de 60k linhas não era algo que eu conseguiria fazer em pouco tempo. O que eu aprendi foi como o npm, o pnpm e o bun funcionam, já que uso Node.js profissionalmente desde o Node.js 0.8 (2012). Também sei quanto teste um software realmente precisa, e como automatizar isso, e não só testar uma vez, faz toda a diferença. Todo aquele pessoal de ágil me mandando escrever os testes primeiro estava certo no fim das contas!
Por que o jpm
Eu estava assistindo a um podcast no YouTube chamado Syntax com os apresentadores Wes, Scott e CJ, em que eles começaram o episódio falando do upm, um gerenciador de pacotes rápido e bem pequeno, só que escrito em JavaScript. A primeira coisa que pensei foi que essa história do tamanho não era verdade, porque você precisa incluir o runtime do Node.js ou algum runtime. Quem escreveu foi o Pooya, e o CJ estava mostrando os benchmarks do próprio projeto, em que ele aparecia rápido, mas eu só queria ver se a gente conseguia deixá-lo mais rápido. O Pooya é um bom engenheiro, que faz muitas ferramentas boas para o ecossistema JavaScript, então eu sabia que não ia ser fácil. Por último, eu vinha usando o Opus 5.5 como modelo e ele estava me impressionando demais. Então pensei: já que tantas outras ferramentas foram feitas em Rust, eles até brincaram com isso no podcast, talvez eu conseguisse fazer um gerenciador de pacotes bem pequeno e rápido em Rust.
No podcast, os apresentadores estavam respondendo perguntas do público sobre IA, perguntas que todo mundo está fazendo agora. Ela consegue construir software de verdade, ou só demos? Os engenheiros deveriam estar preocupados, ou animados? A maioria das pessoas acredita que a IA consegue fazer qualquer coisa de primeira. Spoiler: consegue. Só que os resultados não ficam bons sem direcioná-la e sem entender de desenvolvimento de software.
A tarde
Então, naquela tarde, quando eu estava encerrando o expediente do meu trabalho, abri uma aba no terminal e perguntei ao Claude o que seria preciso para reescrever o upm como uma CLI em Rust. Li o resumo, dei o ok e ele começou. Acho que levou uns 45 minutos e já tinha uma versão funcionando, usando um monte de crates de Rust de terceiros que a deixavam bem maior, e testada só com um package.json pequeno. Para deixá-la menor, pedi que ele destrinchasse o que a deixava tão grande, e até o fim daquela noite eu tinha um módulo próprio de HTTP, JSON, criptografia e TLS e um binário bem menor. Eu orientei que ele escrevesse só as partes de que a gente precisava, mas também que testasse essas partes a fundo com os testes de outros projetos quando desse, ou com os nossos, com um pouco de fuzz testing. Eu queria ter certeza de que estavam sólidas.
Os cinco dias
Então essa é a parte que todo mundo que está fazendo projetos no “vibe coding” deixa de fora. Claro, eu tinha ele funcionando com um package.json pequeno, rodando em Linux no WSL2 do Windows, mas não tinha testado no Mac nem no Windows, nem em nenhum projeto realmente grande. Então pedi para ele escrever um script para deixá-lo robusto, que pegava 100, e no fim 166, projetos públicos grandes e tentava instalar e buildar cada um. Depois instalar e buildar com o gerenciador de pacotes que eles usam e comparar. Incluindo rodar os testes deles quando dava, já que alguns testes precisavam de segredos ou de outra configuração. E fazer isso também na linha de comando do Windows e no PowerShell, enquanto eu subia um agente no meu Mac para fazer o mesmo no Mac. E cinco dias depois, tomando muitas decisões sobre o que suportar e como, tínhamos 261 PRs mergeados e um gerenciador de pacotes robusto e bem testado.
Como foi dirigir
Então eu não escrevi código, mas dirigi e tomei muitas decisões pequenas. Tipo quando o Claude disse que um formato de lockfile mais rápido só economizaria alguns ms, mas eu pedi a mudança mesmo assim. O Claude também queria que o store global fosse um recurso opcional, mas eu questionei: se 99% dos pacotes podem usar, para quê? E virou o padrão. Eu também não queria que ele rodasse scripts, incluindo os scripts de instalação das dependências, a não ser que você os tivesse listado como liberados. Minha ideia aqui era que hoje a IA faz a maior parte do trabalho, então antes de aprovar os scripts de um pacote eu posso simplesmente pedir para ela revisar se há problemas primeiro.
Também teve duas vezes em que o Claude realmente discordou de mim, mas nas duas eu insisti.
A primeira foi com o TLS. Eu queria deixar o binário menor, e os crates de TLS e de criptografia eram uma boa parte disso. O Claude disse que esse é o tipo de código que você nunca escreve por conta própria. Eu disse que isso era um jeito antigo de pensar engenharia. Estamos em Rust, então os bugs de memória por trás de coisas como o Heartbleed estão fora de questão, e a gente pode testar a nossa versão pesado do mesmo jeito, se não melhor. Ele concordou que tinha exagerado o risco e listou quais suítes de testes provariam isso (Wycheproof, vetores do NIST, x509-limbo, BoGo). Eu ainda me pergunto se isso é uma boa ideia ou não, e o Claude adora puxar o saco, então ele dizer que exagerou o risco pode ser só ele querendo agradar. Ele passa em um monte de testes, incluindo testes criados a partir de bugs reais de outros projetos. Sei que hoje eu confiaria muito mais nele, independentemente de quem o escreveu.
A segunda foi com o HTTP/2. Eu queria mais velocidade e perguntei sobre isso. O Claude testou primeiro com o curl e disse que não valia a pena construir, porque a instalação inteira do jpm via HTTP/1.1 já era mais rápida do que só o download do curl via HTTP/2. Eu insisti mesmo assim. O curl tem que lidar com todos os casos, e a gente só precisa de muitos GETs para um único registro. A gente tem que pensar fora da caixa para ganhar do bun. Ele concordou e, umas duas horas depois, tinha um cliente funcionando.
Aí a gente mediu. Na minha conexão de casa, o HTTP/2 era uns 17% mais rápido. Nos runners do GitHub ele empatava ou perdia, chegava a ser 2x mais lento numa instalação a frio do nuxt e usava de 8 a 15% mais CPU com tarballs grandes. O CI é onde as instalações custam tempo e dinheiro de verdade, e ele ainda adicionava 60 KB ao binário. Então mandei apagar todas as 3.671 linhas. Nessa eu estava errado, e os números me mostraram isso.
Também aconteceu o contrário. O jpm instala o Node para você se você quiser, e eu queria a verificação de assinatura do Node atrás de uma flag porque achava que ia deixar as instalações mais lentas. O Claude mediu e deu de 15 a 19 ms, e disse que uma flag só significa que ninguém vai ativar. Ela vem ativada por padrão e fico feliz com isso, porque traz mais segurança.
Por que confio em código que ninguém digitou
A resposta curta é: Wycheproof, os próprios testes do node-semver, do pnpm, do yarn e do bun, e os 166 repos em que testamos. Alguns dos bugs que eles encontraram pelo caminho:
- Os próprios testes do node-semver acharam 25 casos em que o jpm discordava, como aceitar
^9007199254740991.0.0como range. - No começo, os testes do npm-package-arg só batiam em 117 de 154.
a@a.tar.gzera lido como uma tag. - Uma varredura de segurança descobriu que o
.npmrcde um repo clonado podia mandar o seu token do registro pelo próprio proxy. A prova de conceito capturouBearer USER-SECRET-TOKEN. O.npmrcde um projeto não consegue mais diminuir a segurança. - Nos repos reais, os links de dependências em que a instalação do jpm diferia da do pnpm caíram de 1.320 para 183, e em relação à do npm, de 614 para 14.
- No macOS nem compilava até eu testar no macOS.
Também sei, depois de tantos anos construindo software, que nada está livre de bugs, não importa quantos testes você escreva e rode. E confiança se conquista, então pretendo usá-lo em todos os meus projetos daqui pra frente, além de estar aberto a correções, até as enviadas por IA. Isso não quer dizer que vou aceitar todas. Elas precisam provar com testes que estão corrigindo alguma coisa. A questão é que não pretendo desativar os PRs, mas vou usar IA para me ajudar com isso.
Onde ele está hoje
Chegamos a um executável de 2MB, e ele nem sempre é o mais rápido, mas está lá no topo. Também é um dos mais seguros, já que não roda scripts sem aprovação. Não atualiza pacotes para a versão mais recente se ela não tiver pelo menos um dia. E tem a segurança em torno do .npmrc.
Aqui está um dos gráficos mostrando o quanto a gente consegue ser rápido num runner do GitHub Actions comparado com outros gerenciadores de pacotes:
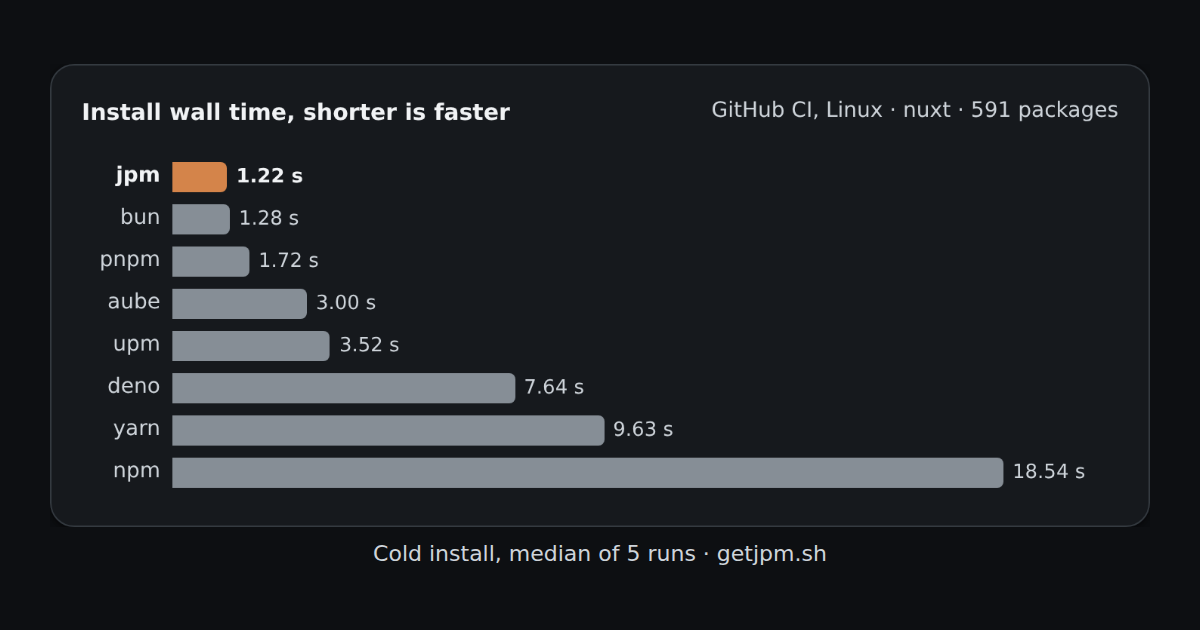
Todas as máquinas, fases e projetos estão em getjpm.sh.
Onde ele não é o mais rápido
Vou ser honesto aqui: o benchmark é pequeno, só três repos. A gente também nem sempre é o mais rápido. Tipo no nuxt no Windows, os scans do Defender estão acabando com ele. No macOS, o bun e o aube ganham nas instalações a quente do nuxt. Então tem espaço para melhorar se velocidade for o objetivo final. A gente rodou instalações de 166 projetos em Linux, macOS e Windows, e ainda mais projetos aleatórios em Linux para achar bugs, mas não testamos a performance de cada um no CI e em máquinas.
O jpm é perfeito? Não. Nem nada do que eu escrevi à mão em 27 anos, nem nada que qualquer ser humano já escreveu. Perfeito não existe. Existe o bom o bastante, existe o ótimo, e existe o testado o bastante para saber qual dos dois você tem.
Experimente com curl -fsSL https://getjpm.sh | sh no macOS e no Linux, ou irm https://getjpm.sh/install.ps1 | iex no Windows, e depois rode jpm install em qualquer projeto. Se achar um bug, abra uma issue no GitHub.